Was bringt uns zehnmal schnelleres Coding, wenn eine Entscheidung weiterhin drei Wochen dauert?
Diese Frage beschäftigt mich zunehmend.
Denn wenn wir aktuell über AI in der Softwareentwicklung sprechen, reden wir sehr schnell über Coding Agents, automatisierte Tests, Copilot, Code Reviews oder generierten Code.
Alles richtig. Alles wichtig.
Aber vielleicht schauen wir gerade auf den falschen Teil des Systems.
Ich erlebe seit Jahren in unterschiedlichen Transformationen, dass Softwareentwicklung häufig gar nicht der größte Engpass ist. Teams können erstaunlich schnell sein.
Was sich dagegen teilweise wie Kaugummi zieht, ist alles davor:
Informationen zusammensuchen. Anforderungen klären. Priorisieren. Entscheidungen treffen. Stakeholder abstimmen. Abhängigkeiten erkennen. Freigaben bekommen.
Wir bauen gerade schnellere Entwickler. Dabei müssten wir schnellere Organisationen bauen.
Kurz gesagt
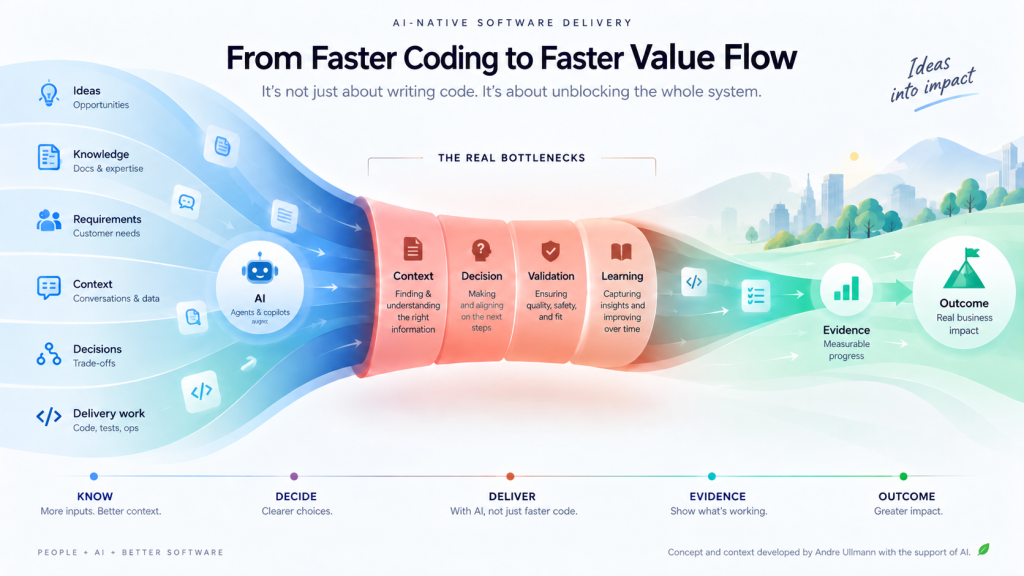
AI-native Software Delivery bedeutet für mich nicht, möglichst viel Software autonom erzeugen zu lassen. Entscheidend ist, den gesamten Value Flow zu beschleunigen – von Kontext und Entscheidungen über Delivery und Validation bis zu belastbarer Evidenz und messbaren Outcomes.
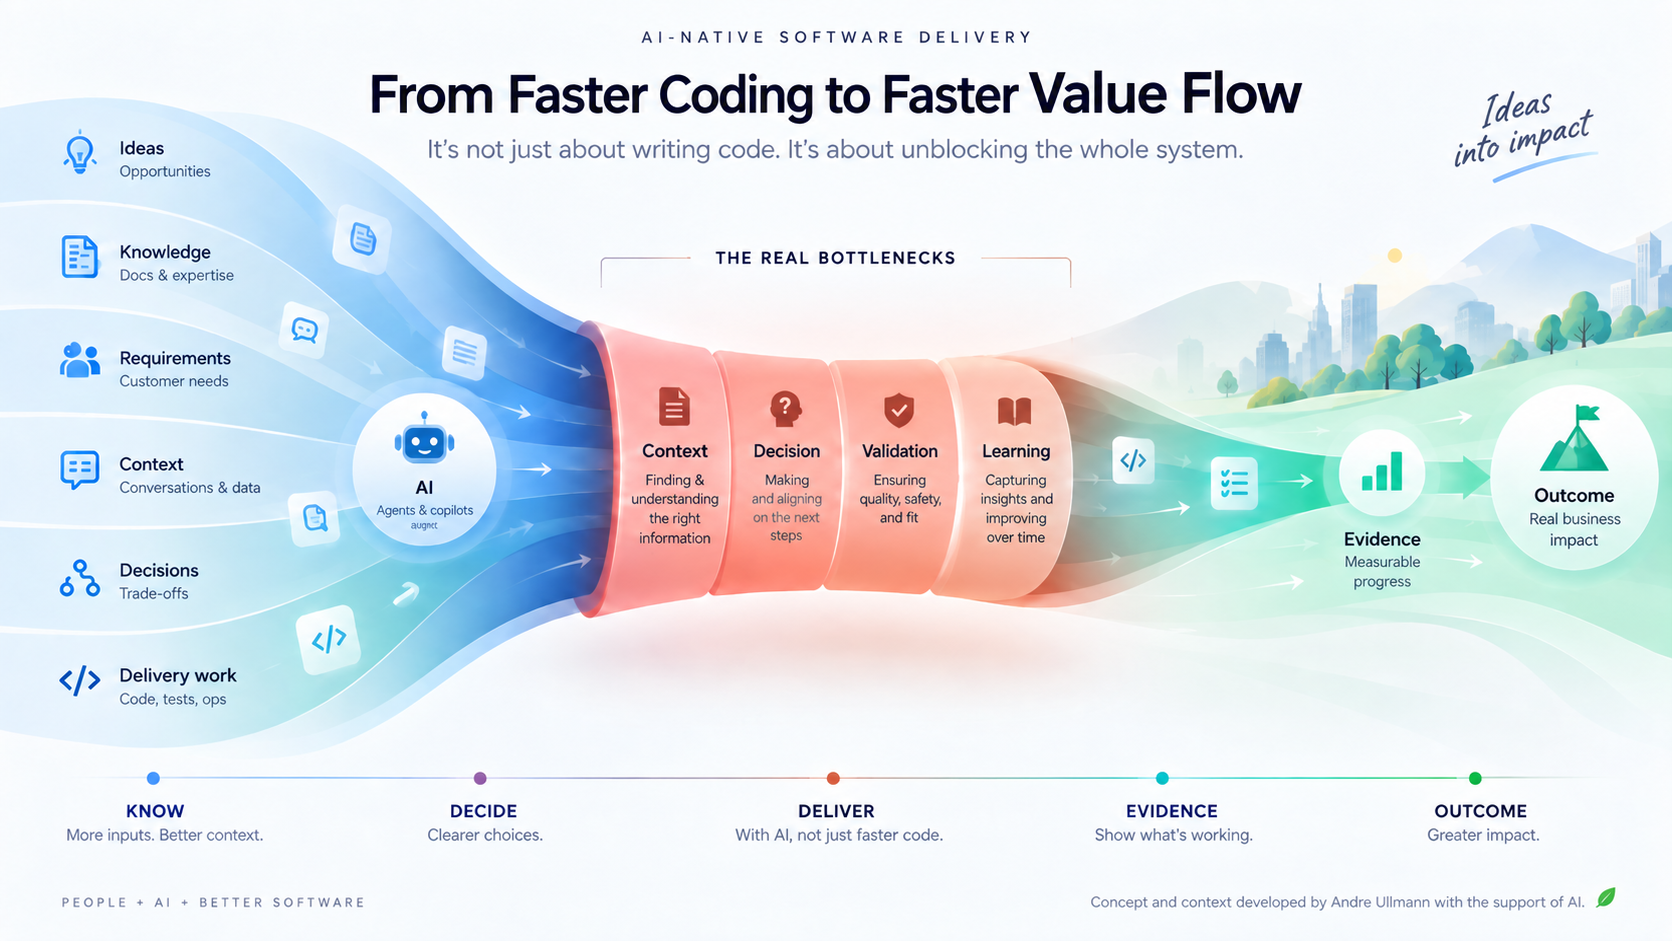
Schneller Code bedeutet noch keinen schnelleren Value Flow
Eine aktuelle NBER-Untersuchung „Writing Code vs. Shipping Code“ macht diesen Effekt erstaunlich sichtbar.
Forscher haben Daten von mehr als 500.000 GitHub-Entwicklern untersucht. Bei autonomen Coding Agents stieg die Coding-Aktivität in der Studie kumuliert um rund 240 Prozent. Beim Übergang zu Projekten blieben davon rund 80 Prozent, bei tatsächlichen Releases noch rund 30 Prozent übrig.
Die Autoren interpretieren dieses Muster als Hinweis darauf, dass starke AI-bedingte Produktivitätsgewinne an anderen Stellen der Produktionskette durch menschliche Bottlenecks abgeschwächt werden.
Wichtig ist dabei: Es handelt sich um ein NBER Working Paper, also um eine wissenschaftliche Untersuchung, aber nicht um eine allgemeingültige Produktivitätsformel für jedes Unternehmen.
Writing Code ist eben nicht dasselbe wie Shipping Code.
Und Shipping Code ist wiederum noch lange nicht dasselbe wie Value.
Genau das beobachte ich auch in der Praxis.
Ich habe Backlogs gesehen, in denen priorisierte Anforderungen teilweise kaum mehr als einen Titel enthielten. Keine ausreichende Beschreibung. Keine klaren Akzeptanzkriterien.
Der Gedanke dahinter war sinngemäß: „Wir wissen schon, was wir machen müssen.“
Das kann funktionieren.
Bis mehrere Teams beteiligt sind. Bis Wissen verloren geht. Bis Entscheidungen nachvollziehbar sein müssen. Bis ein Agent diesen Kontext benötigt. Oder bis jemand drei Monate später verstehen möchte, warum etwas eigentlich gebaut wurde.
AI macht fehlende Klarheit nicht automatisch besser.
Wenn Execution schneller wird, können unklare Anforderungen einfach schneller zu falschen Ergebnissen führen.
Microsoft hat genau dieses Problem erlebt
Interessant ist deshalb die Erfahrung von Microsoft Digital.
Microsoft beschreibt in seinem Beitrag „Engineering the Frontier Firm: Sharing our AI-native approach to software development“, dass Entwickler durch AI individuell schneller wurden, sich dieser Effekt aber nicht automatisch entsprechend in der Teamproduktivität widerspiegelte.
Microsoft führt das unter anderem auf einen Software Development Lifecycle zurück, der stark von menschlichen Übergaben geprägt ist.
Als Konsequenz entwickelt Microsoft einen stärker Spec-Driven-Development-orientierten Ansatz.
Business Intent, Anforderungen, Acceptance Criteria und relevante Constraints werden dabei in einer lebenden Spezifikation durch den Entwicklungsprozess getragen. AI unterstützt unter anderem Implementierung, Testing und Validation – menschliches Judgement und menschliche Validation bleiben aber ausdrücklich Bestandteil des Systems.
Das finde ich bemerkenswert.
Denn die Antwort auf schnellere AI lautet offenbar nicht:
weniger Struktur.
Sondern:
andere – und an entscheidenden Stellen sogar klarere – Struktur.
Der Bottleneck verschiebt sich
Ich habe vor einigen Jahren in einem Unternehmen eine klassische Wertstromanalyse durchgeführt.
In diesem konkreten Fall zeigte sich, dass ungefähr die Hälfte der gesamten Durchlaufzeit aus Wartezeiten bestand. Durch Veränderungen am Flow konnten wir die betrachtete Durchlaufzeit anschließend von ungefähr drei Monaten auf etwa sechs Wochen reduzieren.
Das ist eine einzelne Projekterfahrung und natürlich keine allgemeine Benchmark.
Aber sie hat mir sehr deutlich gezeigt, welches Potenzial außerhalb der eigentlichen Entwicklung liegen kann.
Damals haben wir diese Wartezeiten weitgehend manuell identifiziert.
Heute stellt sich für mich eine zusätzliche Frage:
Was könnten wir inzwischen erkennen und verbessern, wenn AI den kompletten Value Stream analysieren und kontinuierlich begleiten könnte?
Dependencies. Liegezeiten. Wiederkehrende Rückfragen. Fehlende Informationen. Entscheidungsschleifen. Qualitätsprobleme in Anforderungen. Blockaden zwischen Organisationseinheiten.
Genau deshalb reicht es mir nicht, AI ausschließlich innerhalb der Softwareentwicklung zu betrachten.
Wenn AI Execution günstiger und schneller macht, verschiebt sich der Engpass.
Ich sehe dabei insbesondere vier Kandidaten:
Context Bottleneck
Hat der Mensch oder Agent überhaupt den richtigen, aktuellen und vertrauenswürdigen Kontext?
Decision Bottleneck
Kann die Organisation genauso schnell entscheiden, wie AI Optionen erzeugt?
Validation Bottleneck
Können wir schnell genug überprüfen, was AI produziert?
Learning Bottleneck
Erkennen wir schnell genug, ob das Produzierte tatsächlich Wirkung erzielt?
Diese vier Bottlenecks sind keine bestehenden DORA- oder SAFe-Kategorien, sondern mein konzeptionelles Modell zur Weiterentwicklung des AI Agile Bottleneck Shift.
GitHub kommt aus einer anderen Perspektive zu einer ähnlichen systemischen Betrachtung. Im „Agentic Engineering System“ reichen schnelle Agents allein nicht aus. GitHub verbindet agentische Entwicklung unter anderem mit Governance, Shared Knowledge und Customer Value und weist darauf hin, dass steigende Geschwindigkeit bei schwachen Rahmenbedingungen auch Rework, Defects und Risiken verstärken kann.
Vom Delivery Flow zum Learning Flow
Aus diesen Beobachtungen ergibt sich für mich ein einfaches Modell:
KNOW → DECIDE → DELIVER → EVIDENCE → OUTCOME
Nicht als starre neue Prozesskette.
Sondern als Betrachtung der Zeiten, die darüber entscheiden, wie schnell aus einer Idee tatsächlich Wirkung entsteht.
KNOW – Time to Knowledge
Wie schnell besitzt eine Organisation ausreichend Kontext, um ein Problem sinnvoll bearbeiten zu können?
AI kann Informationen aus verschiedenen Quellen zusammenbringen, Feedback analysieren, historische Entscheidungen finden oder Abhängigkeiten sichtbar machen.
DECIDE – Time to Decision
Wie schnell wird aus Wissen eine belastbare Entscheidung?
Hier beginnt für mich einer der spannendsten Bereiche.
Ein Agent kann möglicherweise in Sekunden fünf Optionen erzeugen.
Wenn anschließend drei Meetings, zwei Steering Committees und vier Freigaben erforderlich sind, haben wir technologisch beschleunigt – organisatorisch aber kaum etwas gewonnen.
DELIVER – Time to Delivery
Hier erleben wir derzeit den sichtbarsten AI-Effekt.
Coding, Testing, Dokumentation, Analyse, Refactoring oder Security Checks lassen sich bereits heute zunehmend durch AI unterstützen oder teilweise agentisch ausführen.
Aber Delivery ist nur ein Teil des Systems.
EVIDENCE – Time to Evidence
Für dieses Modell verwende ich deshalb bewusst den Begriff „Time to Evidence“.
Darunter verstehe ich die Zeit zwischen einer umgesetzten Veränderung und dem Zeitpunkt, an dem ausreichend belastbare Evidenz vorliegt, um über ihre tatsächliche Wirkung entscheiden zu können.
Time to Evidence ist keine etablierte DORA- oder SAFe-Metrik, sondern meine Arbeitsdefinition.
Denn:
Delivered ≠ Used ≠ Valuable ≠ Outcome achieved.
Ein Feature kann innerhalb eines Tages gebaut und deployed werden.
Ob Kunden es nutzen, ob Conversion steigt, ob ein Prozess tatsächlich besser wird oder ob wir lediglich mehr Software produziert haben, wissen wir möglicherweise erst deutlich später.
Auch DORA empfiehlt beim Einsatz generativer AI, nicht einfach AI-Adoption zu messen, sondern Baselines zu schaffen, konkrete Outcomes zu definieren, Auswirkungen zu beobachten und iterativ zu lernen.
OUTCOME – Time to Outcome
Am Ende interessiert mich nicht, wie viele Zeilen Code ein Agent erzeugt.
Mich interessiert:
Hat sich für den Kunden oder das Unternehmen etwas messbar verbessert?
Und wie lange hat der komplette Weg dorthin gedauert?
Das Operating Model muss sich mitverändern
Genau an diesem Punkt wird AI aus meiner Sicht zu einem Transformationsthema.
Nicht zu einem Tool-Thema.
Das knüpft für mich unmittelbar an eine grundsätzliche Beobachtung aus der agilen Transformation an: Agile Transformation ist kein Rollout, sondern eine Veränderung des Organisationssystems.
AI verstärkt diese Notwendigkeit noch einmal.
| Heute häufig | Entwicklung zum AI-nativen Operating Model |
|---|---|
| Menschen suchen Informationen zusammen | Agents stellen relevanten Kontext kontinuierlicher bereit |
| Wissen verteilt sich auf Tools, Meetings und Köpfe | Shared Knowledge wird Teil des Systems |
| Refinements bereiten stark Arbeit vor | Menschen fokussieren stärker auf Intent, Entscheidungen und Trade-offs |
| Entwickler erzeugen überwiegend Code | Entwickler gestalten Systeme, orchestrieren und validieren zunehmend AI-Ausführung |
| Tests und Reviews folgen der Umsetzung | Validation wird stärker Bestandteil des kontinuierlichen Flows |
| Reporting erklärt rückblickend | Telemetrie und AI können kontinuierlicher Evidenz bereitstellen |
| Meetings synchronisieren Informationen | Meetings fokussieren stärker auf Entscheidungen, Alignment und Lernen |
| Time to Delivery dominiert | Knowledge, Decisions, Delivery, Evidence und Outcomes werden gemeinsam betrachtet |
Das ist kein Zustand, den Unternehmen morgen einfach „einführen“.
Es ist ein Zielbild beziehungsweise eine Entwicklungsrichtung, deren einzelne Bestandteile heute bereits sichtbar werden.
Auch Scaled Agile beginnt sein Operating Model derzeit in diese Richtung weiterzuentwickeln.
Im Beitrag „AI-Native SAFe: From Outputs to Outcomes“ wird ausdrücklich argumentiert, dass Delivery in einer AI-unterstützten Welt nicht mehr zwangsläufig der primäre Bottleneck ist und sich der Fokus stärker von Outputs zu Outcomes verschieben muss.
Ein konkretes Beispiel ist das neue PI Outcome Planning.
Im AI-Native-SAFe-Modell wird der bisherige zweitägige PI-Planning-Event durch einen eintägigen PI-Outcome-Planning-Event ersetzt. Zusätzlich führt Scaled Agile einen zweistündigen ART Sense and Respond Event pro Iteration ein, der unter anderem Outcome Progress, Kundenfeedback, systemisches Lernen und Workflow-Verbesserungen adressiert.
Die Details beschreibt Scaled Agile in „Reimagining PI Planning and SAFe Events for the Age of AI“.
Ich halte das nicht deshalb für interessant, weil SAFe die Antwort auf diese Entwicklung wäre.
Sondern weil selbst etablierte Operating Models beginnen, auf dieselbe Veränderung zu reagieren.
Das Thema ist deutlich größer als SAFe.
Es betrifft genauso Scrum, LeSS, Kanban oder individuell entwickelte Product Operating Models.
Und was passiert mit unseren Rollen?
Ich glaube nicht daran, dass Product Owner, Developer, Product Manager, Architekten, Scrum Master oder RTEs morgen verschwinden.
Aber ich glaube sehr wohl, dass sich ihre wertvollste Arbeit verschiebt.
| Heute häufig | Zunehmend wichtiger |
|---|---|
| Developer: Code produzieren | Systeme gestalten, Agents steuern, Outputs prüfen |
| Product Owner: Stories verwalten | Intent klären, Entscheidungen treffen, Evidenz interpretieren |
| Product Management: Features managen | Outcomes, Experimente und Product Judgement |
| Architect: Lösungen dokumentieren | Constraints, Guardrails und Technical Intent |
| Scrum Master / Team Coach: Prozesse moderieren | Flow, Human-AI Collaboration und Lernen gestalten |
| RTE: Events und Dependencies orchestrieren | Value Flow, Outcome Alignment und systemisches Lernen |
Ich gehe sogar davon aus, dass wir zunächst zusätzliche AI-spezifische Rollen sehen werden, bevor klassische Rollen verschwinden oder neue Namen bekommen.
Und Unternehmen brauchen dafür Verantwortung.
Nicht nur einen zusätzlichen Copilot-Workshop.
Aus meiner Sicht gehört AI-Transformation deshalb strategisch weit nach oben in die Organisation.
Ob diese Verantwortung am Ende CAIO, AI Transformation Lead oder anders heißt, ist für mich zunächst zweitrangig.
Entscheidend ist:
Jemand muss den gesamten Zusammenhang gestalten.
Von Produktentwicklung über Prozesse und Marketing bis zu Kundenanalyse, Governance, Daten und organisationalem Lernen.
Denn das größte Risiko sehe ich derzeit nicht darin, dass Unternehmen AI gar nicht einsetzen.
Sondern darin, dass überall einzelne gute AI-Initiativen entstehen – ohne gemeinsames Operating Model dahinter.
Vielleicht optimieren wir gerade den falschen Engpass
AI kann Entwicklung massiv beschleunigen.
Das ist eine große Chance.
Aber Lean hat uns schon lange beigebracht:
Wenn wir einen einzelnen Prozessschritt vor einem bestehenden Bottleneck immer weiter beschleunigen, entsteht nicht automatisch mehr Flow.
Im schlimmsten Fall entsteht einfach:
mehr WIP vor dem nächsten Engpass.
Und genau deshalb sollten wir uns weniger fragen:
Wie viel schneller codet unser Entwickler mit AI?
Sondern:
Wie schnell gelangen wir von Intent zu Wissen, von Wissen zu Entscheidung, von Entscheidung zu Delivery, von Delivery zu Evidence und von Evidence zu einem messbaren Outcome?
Vielleicht ist das eine der wesentlich interessanteren AI-Metriken der kommenden Jahre.
Denn AI-native Softwareentwicklung beginnt für mich nicht dort, wo der erste Agent Code schreibt.
Sie beginnt dort, wo wir den gesamten Lern- und Wertstrom neu denken.
Where is your bottleneck now?
Quellen & weiterführende Literatur
- Demirer, M.; Musolff, L.; Yang, L. (2026): Writing Code vs. Shipping Code: Productivity Effects Across Generations of AI Coding Tools. NBER Working Paper 35275.
NBER Originalquelle - Microsoft Digital (2026): Engineering the Frontier Firm: Sharing our AI-native approach to software development.
Microsoft Originalquelle - GitHub (2026): GitHub’s Agentic Engineering System.
GitHub Originalquelle - Scaled Agile (2026): AI-Native SAFe Session 2: From Outputs to Outcomes.
Scaled Agile Originalquelle - Scaled Agile (2026): AI-Native SAFe Session 4: Reimagining PI Planning and SAFe Events for the Age of AI.
Scaled Agile Originalquelle - DORA: How to enable your software delivery teams to innovate with generative AI.
DORA Originalquelle
Transparenzhinweis: Konzept und fachlicher Kontext dieses Beitrags stammen von André Ullmann. Bei Recherche, Strukturierung und redaktioneller Ausarbeitung wurde KI unterstützend eingesetzt. Der Beitrag wurde anschließend inhaltlich geprüft; die redaktionelle Verantwortung liegt bei André Ullmann.
Abbildung: Konzept & Kontext: André Ullmann · Visualisierung mit KI-Unterstützung erstellt.